SEO 작업 전, 수집과 색인은 어떻게 점검할까
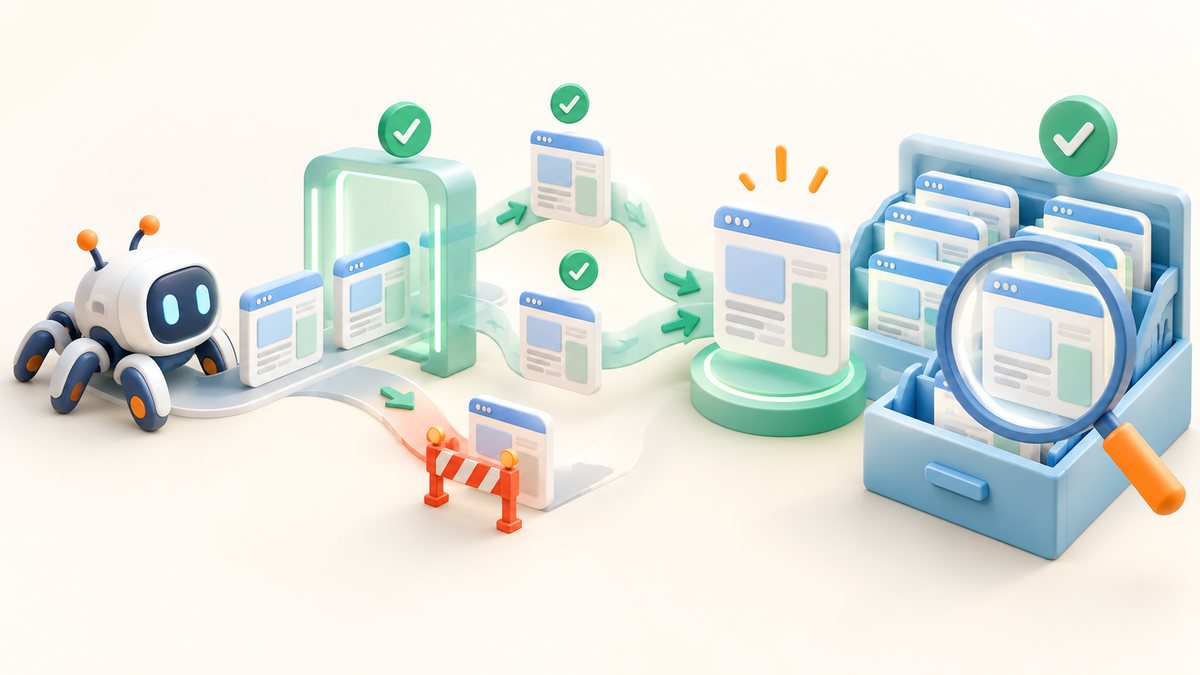
SEO 색인 점검은 검색엔진이 페이지를 수집할 수 있는지, 수집한 페이지를 색인에 올렸는지를 구분해 확인하는 일입니다. robots.txt, HTTP 응답 코드, 사이트맵, 대표 URL과 noindex 설정을 순서대로 보면 대부분의 원인을 좁힐 수 있습니다. 이 점검이 끝나야 제목·콘텐츠 개선 같은 이후 작업이 의미를 갖습니다.
수집과 색인은 무엇이 다른가요?
검색 결과에 페이지가 나오기까지는 크게 세 단계를 거칩니다. 검색엔진이 페이지를 찾아와 읽는 수집(크롤링), 읽은 내용을 분석해 검색 데이터베이스에 저장하는 색인(인덱싱), 검색어에 맞는 문서를 골라 보여 주는 노출(순위 결정)입니다.
세 단계는 서로 독립적이어서, 앞 단계가 통과해도 뒤 단계에서 멈출 수 있습니다.
| 단계 | 의미 | 막히는 대표 원인 |
|---|---|---|
| 수집 | 검색 로봇이 URL에 접근해 내용을 가져옴 | robots.txt 차단, 서버 오류, 접근 제한 |
| 색인 | 가져온 내용을 검색 데이터베이스에 저장 | noindex, 중복 판단, 품질 판단, 대표 URL 불일치 |
| 노출 | 검색어에 맞춰 순서를 정해 보여 줌 | 검색 의도와의 불일치, 경쟁 문서 |
따라서 "수집되었다"와 "색인되었다"는 같은 말이 아닙니다. 구글 서치 콘솔에서 "발견됨 - 현재 색인이 생성되지 않음", "크롤링됨 - 현재 색인이 생성되지 않음" 같은 상태가 따로 있는 것도 이 때문입니다. 점검은 이 단계 중 어디에서 멈췄는지를 찾는 작업입니다.
또한 색인이 되었다고 해서 순위가 보장되지는 않습니다. 색인은 검색 결과에 나올 수 있는 최소 조건일 뿐이며, 순위는 별도의 문제입니다. 사이트 전반의 SEO 개요는 '검색엔진 최적화' 글에서, 네이버와 구글의 차이는 '네이버 SEO'·'구글 SEO' 글에서 다룹니다.
robots.txt는 어떻게 확인하나요?
robots.txt는 사이트 최상위 경로(예: 도메인/robots.txt)에 두는 텍스트 파일로, 검색 로봇에게 어느 경로를 수집해도 되는지 안내합니다. 가장 먼저 볼 항목입니다.
확인 순서
- 브라우저에서
도메인/robots.txt에 직접 접속해 파일이 열리는지 봅니다. User-agent줄이 어떤 로봇을 대상으로 하는지 확인합니다.*는 모든 로봇입니다.Disallow줄에 중요한 경로가 들어 있지 않은지 봅니다.Sitemap줄로 사이트맵 주소가 안내되어 있는지 봅니다.
자주 나오는 실수
- 개발 중 걸어 둔
Disallow: /가 서비스 오픈 후에도 남아 사이트 전체가 차단된 경우 - 이미지·CSS·자바스크립트 경로를 막아 검색엔진이 화면을 제대로 해석하지 못하는 경우
- 색인을 막으려는 목적으로 robots.txt만 사용하는 경우
마지막 항목은 특히 오해가 많습니다. robots.txt는 수집을 막는 도구이지 색인을 막는 도구가 아닙니다. 구글 검색 센터 문서에서도 robots.txt로 차단된 URL이 다른 페이지의 링크 등을 근거로 URL만 색인될 수 있다고 안내합니다. 검색 결과에서 빼려면 페이지에서 로봇이 읽을 수 있는 noindex를 사용해야 하는데, robots.txt로 막아 두면 로봇이 noindex를 읽지 못합니다.
구글 서치 콘솔과 네이버 서치어드바이저에는 robots.txt를 확인하거나 수집 요청을 점검하는 기능이 있으므로, 직접 열어 본 내용과 도구의 판독 결과를 함께 대조하는 것이 안전합니다.
HTTP 응답 코드는 왜 확인해야 하나요?
검색 로봇이 URL에 접속하면 서버는 숫자로 된 응답 코드를 돌려줍니다. 화면에는 정상적으로 보여도 로봇이 받는 코드가 다를 수 있으므로, 중요한 페이지는 코드를 직접 확인해야 합니다. 브라우저 개발자 도구의 네트워크 탭이나 서치 콘솔의 URL 검사 기능으로 볼 수 있습니다.
| 응답 코드 | 의미 | 점검 포인트 |
|---|---|---|
| 200 | 정상 | 색인 대상 페이지의 기본 상태 |
| 301 | 영구 이동 | 주소를 바꿨을 때 새 주소로 연결하는 용도. 연쇄 이동(리디렉션 체인)은 줄이는 편이 좋음 |
| 302 | 임시 이동 | 영구 이동인데 302로 설정된 경우가 없는지 확인 |
| 404 | 페이지 없음 | 삭제된 페이지라면 정상이지만, 살아 있어야 할 페이지라면 문제 |
| 410 | 영구 삭제 | 의도적으로 지운 페이지 |
| 403 | 접근 거부 | 방화벽·보안 설정이 검색 로봇을 막고 있는지 확인 |
| 5xx | 서버 오류 | 반복되면 수집 빈도가 낮아질 수 있음 |
특히 소프트 404를 주의해야 합니다. 내용이 없는 페이지인데 응답 코드는 200으로 나가는 경우로, 검색엔진이 사실상 없는 페이지로 판단해 색인에서 제외할 수 있습니다. 검색 결과가 0건인 목록 페이지, 빈 상품 페이지가 대표적입니다.
또 하나는 접속 환경에 따른 차이입니다. 해외 IP 차단, 로봇 차단용 보안 솔루션, 로그인 요구 같은 설정은 사람이 볼 때는 문제가 없어도 검색 로봇에게는 403이나 로그인 화면으로 보일 수 있습니다. 호스팅이나 보안 설정을 바꾼 이력이 있다면 함께 확인합니다.
사이트맵은 어떻게 제출하고 점검하나요?
사이트맵(sitemap.xml)은 사이트에 있는 URL 목록을 검색엔진에 알려 주는 파일입니다. 사이트맵을 제출했다고 색인이 보장되는 것은 아니며, 검색엔진이 URL을 더 빨리 발견하도록 돕는 보조 수단입니다. 내부 링크가 잘 연결된 작은 사이트는 사이트맵 없이도 수집되지만, 페이지가 많거나 새로 만든 사이트에서는 점검 가치가 큽니다.
제출 방법
- 사이트맵 파일을 만들고
도메인/sitemap.xml에서 열리는지 확인합니다. 대부분의 CMS와 쇼핑몰 솔루션은 자동 생성 기능이나 플러그인을 제공합니다. - 구글 서치 콘솔의 '사이트맵' 메뉴에 주소를 입력합니다.
- 네이버 서치어드바이저의 '요청 > 사이트맵 제출' 메뉴에 주소를 입력합니다.
- robots.txt에도
Sitemap:줄로 주소를 적어 둡니다.
사이트맵에서 확인할 것
- 사이트맵에 200 응답이 나오는 대표 URL만 담겨 있는지
- 404, 리디렉션되는 주소, noindex 페이지, robots.txt로 막은 주소가 섞여 있지 않은지
- http와 https, www 유무 등 주소 형식이 실제 대표 URL과 일치하는지
- 페이지를 추가·삭제한 뒤 사이트맵이 갱신되는지
- 한 파일당 URL 50,000개 이하, 용량 50MB 이하라는 구글의 사이트맵 규격을 넘지 않는지
제출 후에는 서치 콘솔의 사이트맵 보고서에서 '성공' 상태인지, 발견된 URL 수가 예상과 비슷한지 확인합니다. 제출한 URL 수와 색인된 URL 수의 차이는 다음 단계에서 원인을 찾는 출발점이 됩니다.
색인되지 않을 때는 어떤 원인을 의심하나요?
수집은 되는데 색인이 되지 않는다면, 서치 콘솔의 '페이지 색인 생성' 보고서와 URL 검사 결과에 나오는 사유 문구를 먼저 읽습니다. 사유별로 흔한 원인과 대응은 다음과 같습니다.
| 상태·사유 | 흔한 원인 | 확인·대응 |
|---|---|---|
| noindex 태그로 제외됨 | meta robots 또는 X-Robots-Tag 헤더에 noindex가 있음 | 의도한 설정인지 확인하고, 아니면 제거 |
| 대체 페이지(올바른 표준 태그 포함) | canonical이 다른 URL을 가리킴 | 대표 URL로 지정한 주소가 맞는지 확인 |
| 중복 페이지 | 비슷한 내용의 URL이 여러 개이고 검색엔진이 다른 URL을 대표로 선택 | 주소 통일, canonical·301 정리 |
| 발견됨 - 현재 색인 미생성 | URL은 알지만 아직 수집하지 않음 | 내부 링크 보강, 서버 응답 속도와 오류 확인 |
| 크롤링됨 - 현재 색인 미생성 | 수집했지만 색인할 가치가 낮다고 판단했을 가능성 | 내용의 독자성과 분량, 검색 의도 충족 여부 점검 |
| 소프트 404 | 내용이 거의 없는데 200 응답 | 내용 보강 또는 404·410 처리 |
콘텐츠 측면의 원인
기술 설정에 문제가 없는데도 색인되지 않는다면 페이지 자체의 문제일 수 있습니다. 다른 페이지와 거의 같은 내용, 짧고 정보가 부족한 글, 어디에서도 링크되지 않은 고립된 페이지(고아 페이지)가 여기에 해당합니다. 이 경우 수집 요청을 반복하기보다 내용을 보강하고 관련 페이지에서 내부 링크를 연결하는 쪽이 효과적일 수 있습니다.
하지 말아야 할 대응
색인을 빠르게 하겠다며 자동화 도구로 수집 요청을 대량으로 반복하거나, 품질이 낮은 페이지를 대량 생산하는 방식은 권하지 않습니다. 검색엔진의 스팸 정책에 어긋날 수 있고, 근본 원인을 해결하지 못합니다.
참고할 점
새 사이트나 새 글은 정상이어도 색인까지 며칠에서 수 주가 걸릴 수 있습니다. 기간을 단정하기보다, 등록 후 일정 기간이 지나도 상태가 바뀌지 않을 때 위 표의 순서대로 원인을 좁혀 가는 것이 합리적입니다. 네이버는 구글과 수집·색인 기준이 달라 서치어드바이저의 웹 페이지 수집 현황과 진단 메뉴를 별도로 확인해야 합니다.
상담에서 확인하면 좋은 질문
SEO 색인 점검을 외부에 맡기거나 상담받을 때는 점검의 범위와 보고 방식을 먼저 확인하는 것이 좋습니다. 아래 질문을 기준으로 삼아 볼 수 있습니다.
- 점검 범위: robots.txt, 응답 코드, 사이트맵, canonical, noindex를 모두 확인하나요? 네이버와 구글을 각각 보나요?
- 진단 근거: 서치 콘솔·서치어드바이저의 어떤 화면과 지표를 근거로 판단하나요? 결과를 화면이나 표로 공유받을 수 있나요?
- 작업 내역 공유: 설정을 바꾼 항목과 바꾸기 전 상태를 기록해 알려 주나요? 4.
- 정책 준수: 수집 요청 남용이나 저품질 페이지 대량 생성처럼 검색엔진 정책에 어긋나는 방법을 쓰지 않나요?
- 접근 권한: 서치 콘솔·서치어드바이저 권한을 어떤 범위로 요청하고, 종료 후 어떻게 정리하나요?
- 후속 작업 구분: 점검 이후 제목·설명, 내부링크, 구조화 데이터, 콘텐츠 개선 중 무엇이 필요한지 우선순위를 나눠 주나요?
색인 상태가 걱정되는 사이트라면 위 질문을 기준으로 SEO 색인 점검의 범위부터 정리해 보시기 바랍니다.
자주 묻는 질문
색인 여부는 어디서 가장 빨리 확인하나요?
구글은 서치 콘솔의 URL 검사 기능, 네이버는 서치어드바이저의 웹 페이지 수집 관련 메뉴에서 확인할 수 있습니다. 검색창에 `site:도메인` 형태로 입력해 보는 방법도 있으나 정확한 수치는 아니므로 참고용으로만 쓰는 것이 좋습니다.
사이트맵을 제출하면 바로 색인되나요?
그렇지 않습니다. 사이트맵은 URL을 알려 주는 보조 수단이며, 색인 여부는 검색엔진이 페이지의 접근성과 품질을 판단해 정합니다.
robots.txt로 막으면 검색 결과에서 사라지나요?
반드시 그렇지는 않습니다. robots.txt는 수집을 막을 뿐이며, 다른 곳의 링크 등을 근거로 URL이 노출될 수 있습니다. 노출을 막으려면 noindex를 쓰되 로봇이 페이지를 읽을 수 있어야 합니다.
점검은 얼마나 자주 해야 하나요?
정해진 주기는 없습니다. 사이트 개편, 주소 변경, 호스팅·보안 설정 변경, 대량 페이지 추가 직후에 점검하고, 평소에는 서치 콘솔의 알림과 보고서를 주기적으로 보는 방식이 일반적입니다.
블로그 글도 색인 점검이 필요한가요?
네, 필요합니다. 다만 플랫폼형 블로그는 robots.txt나 서버 설정을 직접 바꾸기 어려워, 발행 설정과 검색 허용 옵션, 서치어드바이저 등록 상태 위주로 확인합니다.
더 자세한 서비스 안내: 검색엔진 최적화, 어디까지 해야 할까: SEO 서비스 전체 안내